엑셀 / 특정 문자 앞, 특정 문자 뒤 텍스트 추출하는 방법
특정 문자 앞부분은 LEFT와 FIND, 뒷부분은 RIGHT·LEN·FIND로 추출할 수 있습니다. 예를 들어 @의 위치를 구해 그 앞뒤를 나눕니다. 같은 구분자가 여러 개라면 기본 FIND는 첫 위치를 사용하므로 어느 구분자를 기준으로 할지 먼저 정하세요.
구분자 앞부분 추출
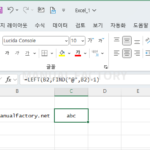
=LEFT(B2,FIND("@",B2)-1)
B2의 abc@manualfactory.net에서 @ 앞의 abc를 추출한 예입니다. FIND의 결과 4에서 구분자 자체 한 글자를 제외하려고 1을 뺍니다.

구분자 뒷부분 추출
=RIGHT(B2,LEN(B2)-FIND("@",B2))
같은 문자열에서 @ 뒤의 manualfactory.net을 추출한 예입니다. 전체 길이에서 구분자 위치를 빼면 오른쪽에서 가져올 문자 수가 됩니다.

한 글자 구분자 대신 여러 글자 구분자를 사용할 때는 구분자 길이까지 고려해야 합니다. 예를 들어 :: 뒤를 MID로 가져오려면 =MID(B2,FIND("::",B2)+LEN("::"),LEN(B2))처럼 시작 위치를 정할 수 있습니다.
구분자가 없거나 여러 개일 때
구분자가 없으면 FIND는 #VALUE! 오류를 반환합니다. 이 경우 ‘빈 문자열’로 처리할지 ‘원본 그대로’ 둘지 또는 오류 안내를 할지 정하세요. 무조건 빈 문자열로 감추면 잘못된 데이터가 누락된 것처럼 보일 수 있습니다.
A@B@C에서 기본 앞부분 수식은 A, 뒷부분 수식은 B@C입니다. 마지막 구분자 기준 또는 두 번째 구분자 기준 작업은 다른 수식이 필요합니다. 대소문자 구분도 FIND·SEARCH에 따라 달라집니다.
TEXTBEFORE·TEXTAFTER 대안
=TEXTBEFORE(B2,"@")
=TEXTAFTER(B2,"@")
지원되는 Excel에서는 구분자 앞뒤를 직접 표현할 수 있습니다. instance_num로 몇 번째 구분자를 사용할지 지정하고 음수로 끝에서부터 지정하는 옵션도 있습니다. 구형 Excel에서는 사용할 수 없으므로 공식 문서의 지원 제품과 미일치 처리 인수를 확인하세요.
구문과 지원 제품은 Microsoft의 LEFT 함수 설명, Microsoft의 RIGHT 함수 설명, Microsoft의 LEN 함수 설명, Microsoft의 TEXTBEFORE 함수 설명, Microsoft의 TEXTAFTER 함수 설명에서 확인할 수 있습니다.
이 방법은 문자열 분리이며 이메일 주소의 유효성까지 검사하지 않습니다. 이메일 사용자 부분만 다룰 때의 주의점은 이메일 앞부분 추출에서 확인할 수 있습니다.
그림으로 복사 기능으로 셀 범위를 이미지로 붙여넣는 방법을 설명합니다. 화면·인쇄 모양과 그림·비트맵 형식, 선명도 및 데이터 편집의 차이를 다룹니다.
엑셀 / 함수 / EVEN, ODD / 짝수 또는 홀수로 올림 또는 내림하는 함수
EVEN과 ODD가 0에서 멀어지는 방향으로 짝수·홀수를 만드는 원리를 설명합니다. 음수와 0 예제로 ISEVEN·ISODD의 판별 기능과 구분할 수 있습니다.
AVERAGE·GEOMEAN·HARMEAN의 계산 의미와 선택 기준을 비교합니다. 복리 성장률·같은 거리의 속도 예제 및 양수 조건을 설명합니다.
엑셀 / 빈 셀, 빈 셀이 있는 행, 빈 셀이 있는 열 삭제하는 방법
이동 옵션으로 실제 빈 셀을 선택하고 셀·행·열을 삭제하는 방법을 설명합니다. 일부만 빈 행과 완전히 빈 행의 차이, 행 데이터가 어긋나는 위험도 다룹니다.
이메일의 @ 앞 사용자 부분을 추출하는 수식과 예제를 안내합니다. 누락·중복 @ 및 공백 처리와 개인정보 식별의 한계도 설명합니다.

엑셀 / 날짜를 텍스트로, 텍스트를 날짜로 변환하는 방법
TEXT·DATEVALUE로 날짜와 텍스트를 변환하는 방법을 설명합니다. 일련번호·표시 형식의 차이와 지역별 문자열 해석, 값으로 저장하는 과정도 다룹니다.
엑셀 / 하이퍼링크 제거하는 방법, 자동 하이퍼링크 안 생기게 하는 방법
기존 하이퍼링크를 제거하거나 입력 시 자동 생성을 끄는 방법을 설명합니다. 텍스트·서식 보존과 HYPERLINK 수식의 별도 처리도 안내합니다.
엑셀 / 피벗 테이블 / 여러 범위로 다중 피벗 테이블 만드는 방법
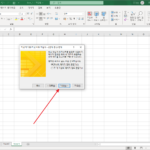
기존 다중 통합 범위 피벗 마법사로 여러 요약 범위를 합치는 방법을 설명합니다. 필드 분석의 한계·범위 추가·새로 고침과 Power Query 대안도 다룹니다.

엑셀 / 함수 / SUBSTITUTE / 문자열 바꾸기
SUBSTITUTE로 특정 텍스트를 모두 또는 지정한 번째만 바꾸는 예제를 안내합니다. 대소문자 처리와 숫자·날짜를 텍스트로 가공할 때의 주의점도 설명합니다.
엑셀 / 함수 / COUNT, COUNTA, COUNTBLANK, COUNTIF, COUNTIFS
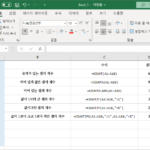
COUNT·COUNTA·COUNTBLANK·COUNTIF·COUNTIFS의 계산 대상을 비교합니다. 수식 빈 문자열, 공백과 0의 처리 및 조건별 개수 예제를 설명합니다.